Unsloth — сейчас один из самых быстрых способов сделать файнтюнинг (LoRA/QLoRA) LLM прямо на GPU. В официальных требованиях написано «NVIDIA GPU с 2018 года, минимум CUDA 7.0 (V100, T4, Titan V…)», но на деле официальный Docker-образ на моих картах 2017 года отказался даже стартовать. Что не так и как я это починил — в этой статье, с командами по шагам.
Моё железо
- 2x Tesla V100-SXM2-16GB (Volta, sm_70) — 32 GiB VRAM суммарно;
- Ubuntu-сервер, Docker + NVIDIA runtime.
Почему официальный образ не стартовал
Документация Unsloth обещает поддержку V100. Но образ unsloth/unsloth:latest из Docker Hub — это PyTorch 2.11, и тут две проблемы сразу:
- entrypoint-скрипт содержит жёсткий гейт: compute capability ниже sm_75 (Turing) — и контейнер просто не поднимается. Гейт — одно
ifв/usr/local/bin/unsloth-entrypoint; - даже сняв гейт, torch 2.11 не поможет: PyTorch с версии 2.11 сознательно выпилил Volta (sm_70) из CUDA-12.8 билдов. В vLLM-колёсах cu128 уже нет SASS под sm_70.
То есть документация про V100 актуальна для установки через pip, а свежий Docker-образ о V100 «забыл».
Что именно я установил
Решение — свой образ поверх официального. Нужно зафиксировать PyTorch на 2.10 (последний релиз, у которого в cu128-колёсах ещё есть sm_70) и снять гейт в entrypoint:
- torch 2.10.0+cu128 в обоих venv (в образе их два — базовый и Studio);
- xformers 0.0.35 — проверил, что импортируется под torch 2.10, оставил;
- vLLM и torchcodec — убрал: они жёстко привязаны к torch 2.11 и для web-UI не нужны;
- entrypoint — патч одной строкой через
sed.
Полный Dockerfile — около 40 строк:
FROM unsloth/unsloth:latest

ARG TORCH=2.10.0
ARG TORCHVISION=0.25.0
ARG TORCHAUDIO=2.10.0
ARG XFORMERS=0.0.35

ENV TORCH_CUDA_ARCH_LIST="7.0;7.5;8.0;8.6;8.9;9.0;10.0;12.0+PTX"

# Базовый venv: заменяем torch-стек на 2.10.0+cu128
RUN VENV=/opt/unsloth-venv \
 && $VENV/bin/pip uninstall -y vllm torchcodec xformers \
 && $VENV/bin/pip install -U \
      --extra-index-url https://download.pytorch.org/whl/cu128 \
      "torch==${TORCH}" "torchvision==${TORCHVISION}" "torchaudio==${TORCHAUDIO}" \
 && $VENV/bin/pip install --no-deps "xformers==${XFORMERS}"

# venv Studio: тот же torch, nvidia-библиотеки — симлинки на базовый venv
RUN SVENV=/opt/unsloth-studio-app/unsloth_studio \
 && $SVENV/bin/pip uninstall -y torchcodec \
 && $SVENV/bin/pip install --no-deps \
      --extra-index-url https://download.pytorch.org/whl/cu128 \
      "torch==${TORCH}+cu128" "torchvision==${TORCHVISION}+cu128" "torchaudio==${TORCHAUDIO}+cu128"

# Снимаем sm_75-гейт в entrypoint
RUN sed -i 's/if major < 7 or (major == 7 and minor < 5):/if False:  # v100-patch: allow sm_70 (V100)/' \
      /usr/local/bin/unsloth-entrypoint
По шагам: команды установки
1. Подтягиваем официальный образ
docker pull unsloth/unsloth:latest2. Собираем свой
mkdir -p ~/unsloth-v100 && cd ~/unsloth-v100
# кладём Dockerfile (см. выше)
docker build -t unsloth/unsloth-v100:latest .
3. Запускаем контейнер
docker run -d --name unsloth-ui --restart unless-stopped \
  --gpus all -e CUDA_VISIBLE_DEVICES=0,1 \
  -p 8000:8000 -p 8888:8888 \
  -e UNSLOTH_STUDIO_PASSWORD=*** \
  -e JUPYTER_PASSWORD=*** \
  -v unsloth-studio-data:/root/.unsloth \
  -v unsloth-ws:/workspace \
  unsloth/unsloth-v100:latest
Готово: Studio — на :8000, JupyterLab — на :8888.
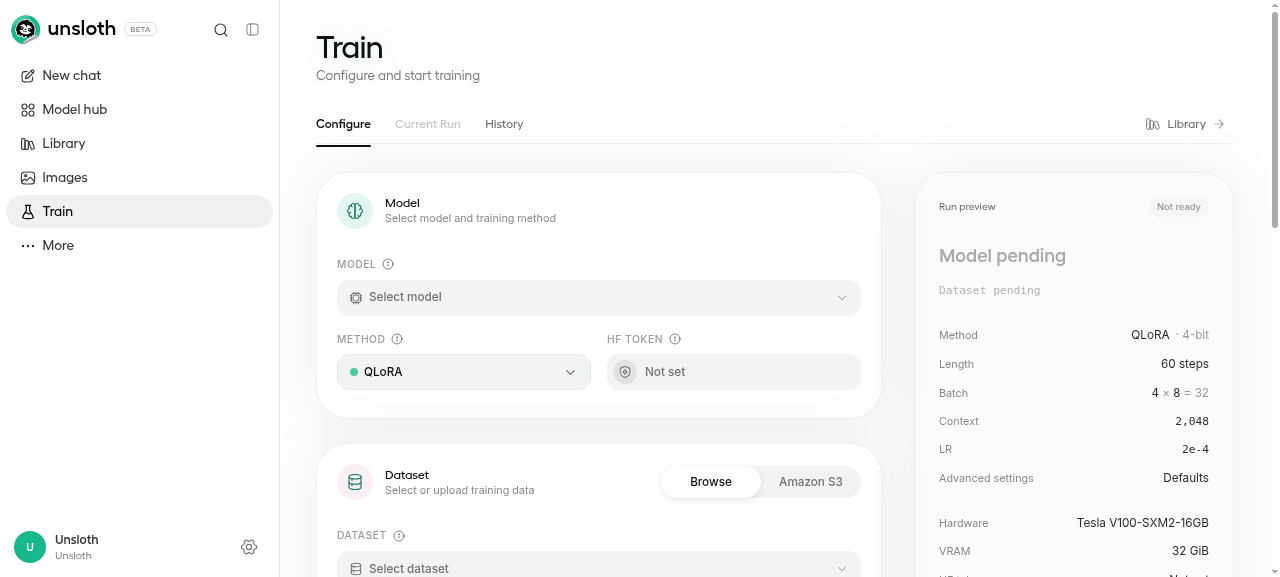 Страница Train: справа Run preview — видно обе V100 и 32 GiB VRAM
В Run preview сразу видно, что всё подключилось правильно: Hardware: Tesla V100-SXM2-16GB, VRAM: 32 GiB.
Подводные камни
bf16 на V100 нет
Volta не знает bfloat16 — Unsloth сам переключается на fp16. Обучение идёт нормально. Но если на чувствительной модели увидите скачки loss — помните про точность: fp16 + grad-accumulation безопаснее для мелких батчей.
Отдельно осторожно с full fine-tuning (не QLoRA) и с GRPO. Если модель в bf16, на V100 Unsloth может попытаться сохранить float32 или войти в bf16-autocast, и обучение упадёт или застрянет. Для V100 всегда явно указывайте dtype=torch.float16 — и для QLoRA, и для full fine-tuning.
«Побитые» загрузки — проверьте RAM
По пути поймал странность: docker pull стабильно падал с unpigz: invalid compressed data--crc error на одном и том же слое. При этом контрольная сумма того же бина на другом хосте совпадала. Проверка в три строки (три sha256-чтения файла из RAM) дала три разных хеша — планки тихо битили биты, ECC отсутствует. После замены оперативки всё стало ходить.
Вывод: если docker pull умирает по CRC, а зеркала чистые — подозревайте RAM/сеть, а не реестр.
Что работает, что нет
- Работает: QLoRA 4bit-обучение (Qwen2.5-0.5B-bnb-4bit, LoRA r=16: 8 шагов за 11.7 c, loss 3.09 → 2.64), xformers-внимание, весь web-UI (Studio + Jupyter), llama.cpp-бэкенд (предсобранный, sm_70 на месте);
- Не работает: официальный образ «из коробки», bf16.
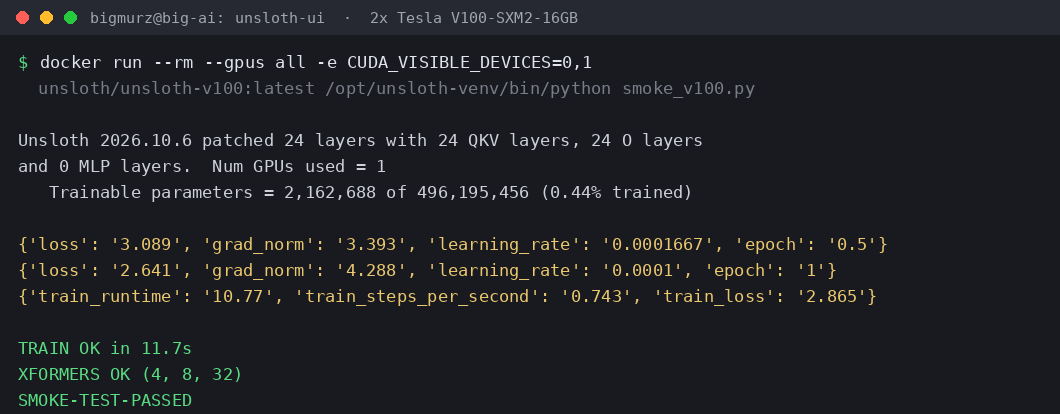 Тестовое QLoRA-обучение: 8 шагов за 11.7 c, loss 3.09 → 2.64
Это реальный лог smoke-теста: маленькая модель — чтобы проверить конвейер, а не скорость. На 32 GiB уже 7B-14B модели в 4bit QLoRA с контекстом ~2048 укладываются комфортно, 32B — с двойной квантизацией и скромным контекстом, 70B — только с offload/multi-GPU.
Скриншоты
 Вход в Studio — только пароль (логин unsloth)
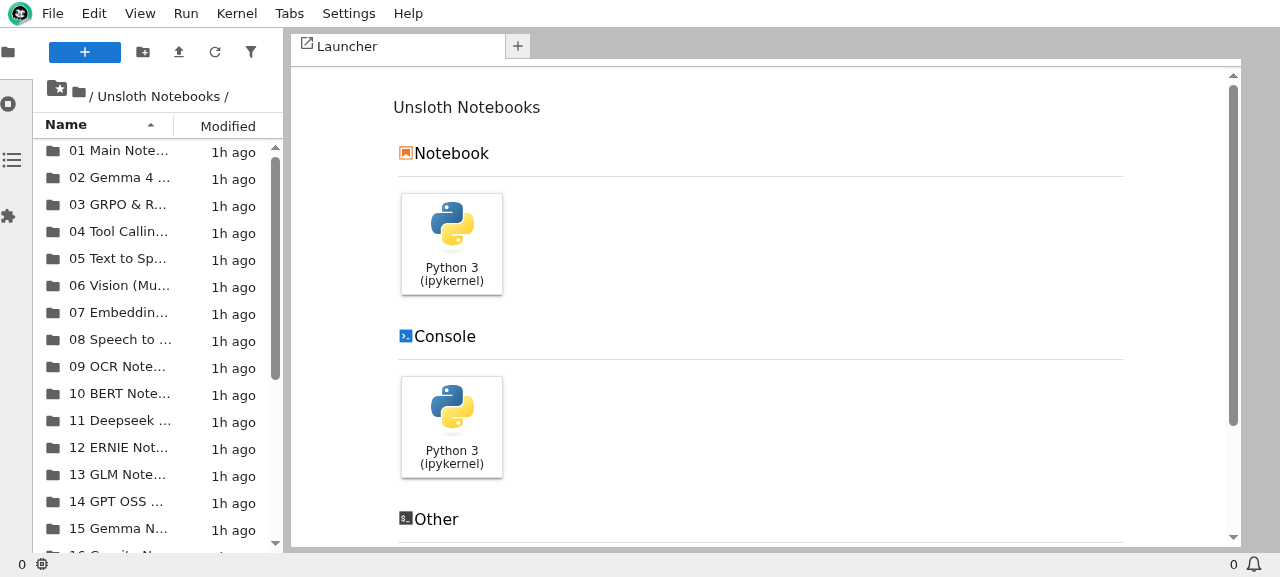 JupyterLab (:8888) с официальными ноутбуками Unsloth
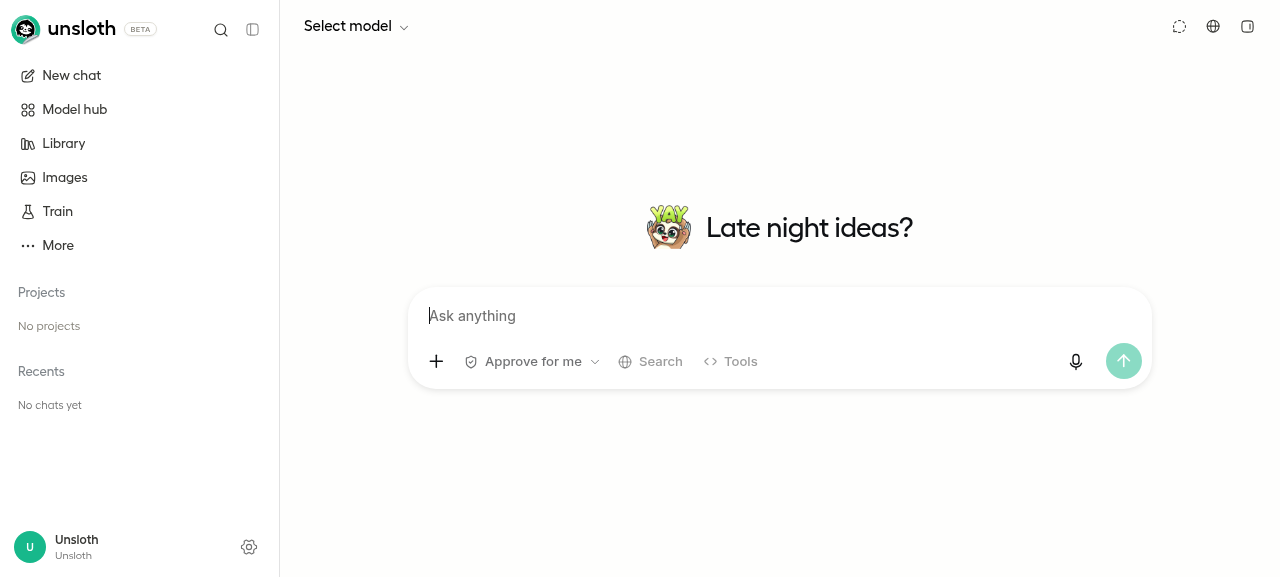 Чат (LLM-инференс) тоже живёт в Studio
Советы (от себя)
- Перед сборкой проверяйте, что реально лежит в колёсах:
python -c "import torch; print(torch._C._cuda_getArchFlags())"иcuobjdump --list-elf libtorch_cuda.so | grep sm_. Это сразу показывает, какие sm_* присутствуют — и не нужно гадать по версии; - В образе Unsloth два venv (базовый и Studio) — синхронизируйте в них одну версию torch, иначе Studio начнёт ругаться на ABI;
- Если ставите Unsloth через
pip, а не Docker, проверьте, какое CUDA-семейство выбрал установщик. Драйвер 580 может подтолкнуть его кcu130, который не покрываетsm_70. Для V100 нужно принудительно указатьcu126илиcu128— тамsm_70ещё есть; - Обновите память, если у вас сервер без ECC и странные CRC-ошибки при больших загрузках. Дёшево, а снимает целый класс «мистических» сетевых багов.
Ссылки
- PyTorch: выпадение Volta из 2.11 — github.com/pytorch/pytorch/issues/172351
- Требования Unsloth — unsloth.ai/docs/…/unsloth-requirements
- Официальный образ — hub.docker.com/r/unsloth/unsloth
- PR с новыми Docker-образами, где cu128-колёса собираются с
sm_70— github.com/unslothai/unsloth/pull/5748 - PR, чинящий выбор CUDA-колёс под архитектуру GPU (актуально для pip-установки) — github.com/unslothai/unsloth/pull/7814