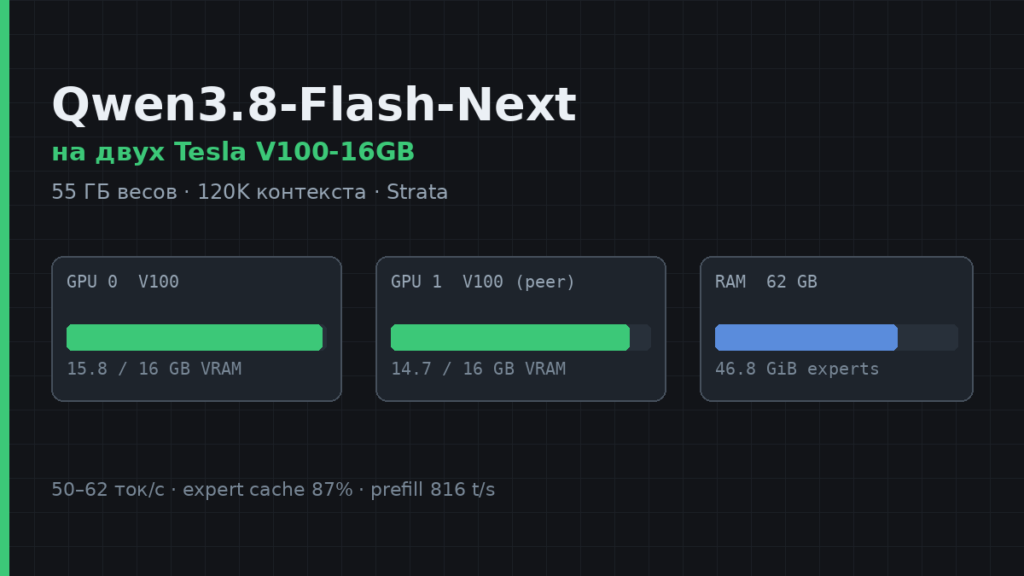
На домашнем сервере у меня две Tesla V100 по 16 ГБ. Это 32 ГБ видеопамяти, и для большинства моделей 2026 года этого уже мало. А тут на глаза попалась Qwen3.8-Flash-Next — MoE-модель, у которой только весов ~55 ГБ. В VRAM она не влезает никогда, сколько карт ни поставь. Спас Strata — движок, который держит «мозги» модели в обычной оперативке, а на GPU оставляет только кэш самых горячих экспертов. В этой статье — как я поднимал Strata на V100, как всё падало с out of memory и как в итоге выжал контекст в 120K токенов. Всё по шагам, с реальными логами и цифрами.
Железо и задача
- Сервер: Intel i7-7700 (4 ядра / 8 потоков), 62 ГБ RAM, Ubuntu 24.04.
- GPU: 2x Tesla V100-SXM2-16GB, соединены NVLink.
- Модель:
Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S— два GGUF-файла, 54.8 ГБ + 28.8 ГБ (PLE-таблица). - Движок: Strata 0.1.42, CUDA 12, Docker-образ
strata-v100.
Идея Strata простая и красивая: у MoE-модели в каждый момент времени «активны» далеко не все эксперты. Значит, все 24576 экспертов можно держать в RAM, а на видеокарте — только те ~4–5 тысяч, которые реально дёргаются чаще всего (по заранее снятому профилю маршрутизации). Остальные подтягиваются по PCIe. Так 55-гигабайтная модель живёт на картах, у которых на двоих 32 ГБ.
Установка
Всё заворачивается в контейнер. Ключевое — конфиг /opt/strata-data/config/strata-iq3_s.json. Вот он целиком в финальном, рабочем виде:
{
 "exe": "/opt/strata/engine-cuda12/strata",
 "args": [
  "--pack", "/data/packs/iq3_s",
  "--native", "/data/models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf",
  "--ple-gguf", "/data/models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf",
  "--expert-profile", "/opt/strata/data/expert-profile.bin",
  "--expert-cache", "auto",
  "--prefill", "auto",
  "--spec", "4",
  "--spec-min-p", "0.5",
  "--mtp", "/data/mtp/rt",
  "--max-context", "122880",
  "--kv", "q4_0",
  "--peer-device", "1",
  "--remote-expert-opt",
  "--peer-reserve-mib", "2048",
  "--kv-resident", "20480"
 ],
 "model_name": "qwen3.8-flash-next-iq3_s",
 "port": 8080,
 "cuda": 12,
 "gpu": [0, 1],
 "host": "0.0.0.0"
}
Разбор главных флагов:
--expert-cache auto— сколько экспертов влезает в VRAM, движок считает сам.--peer-device 1— вторая карта (GPU 1) работает как «peer tier»: держит дополнительный слой экспертов и считает их строки по P2P.--max-context— размер контекста, под который резервируется KV-кэш.--kv— формат KV-кэша:fp16/int8/q4_0.--spec 4+--mtp— спекулятивная генерация (MTP-драфты), сильно ускоряет вывод.
Первый запуск: всё взлетело
Стартовая конфигурация была на layer_split auto — движок сам режет слои модели между двумя картами. Загрузка весов:
[strata] loading the experts into RAM (about 55 GB) and locking part of them for the GPU.
[strata] experts loaded: 46.84 GiB at 2.54 GiB/s (31 s so far)
[strata] filling the GPU's expert cache (4596 experts, 8.27 GiB of VRAM) ...
ready: http://127.0.0.1:8080/v1  (OpenAI: /v1/chat/completions, context 122880 tokens)
Всё красиво: 46.8 ГБ экспертов легли в RAM за полминуты, кэш в 8.27 ГБ занял VRAM, сервер поднялся. Контекст 122880, скорость ~50–60 ток/с. Живи и радуйся.
Эксперимент, который всё сломал
Захотел выжать больше — включил --peer-device 1, чтобы вторая карта разгрузила первую и подняла hit-rate кэша экспертов. И Strata перестал стартовать вообще. Лог краша:
strata generate: peer GPU 1: 7738 experts, 14.71 GiB (filled in 3.4 s);
                 with the primary's 4068 that is 11806 of 24576 on the GPUs
strata serve: the accepted VRAM plan lends the prompt path 2192 cache slots (4.12 GiB)
strata serve: prefill peer: the peer's buffers do not fit
              (raise --peer-reserve-mib or lower --peer-prefill-rows)
              - the prompt path stays on the primary GPU
gather_rows: out of memory
EngineDied: the engine exited before it was ready
Что произошло. С --peer-device меняется топология: GPU 1 забивается экспертами под завязку (7738 штук = 14.71 ГБ из 16), а весь prompt-путь, attention и KV-кэш остаются на GPU 0. И вот на GPU 0 при сборке строк (gather_rows) память кончилась. Движок честно подсказывает в том же логе: мол, буферы peer не влезают, подними --peer-reserve-mib или уменьши --peer-prefill-rows.
Лечение: резерв на peer-карте
Первое, что починило запуск — резерв памяти под prefill-буферы на второй карте плюс поменьше контекст:
--max-context 65536 --kv int8 --peer-device 1 --remote-expert-opt --peer-reserve-mib 2048Взлетело за ~40 секунд, expert cache 4473 слота / 8.47 ГБ. Но 65536 контекста меня не устраивало — нужно 120K.
Возврат 120K: KV в 4 бита + стриминг
Чтобы вернуть 122880 на peer-топологии, ужал сам KV-кэш. Два рычага из --help:
--kv q4_0— 4-битный KV после Hadamard-поворота: вдвое меньше, чем int8.--kv-resident 20480— KV-стриминг: в VRAM держится только 20480 позиций, остальное стримится из RAM, а логический--max-contextне меняется.
Финальный запуск:
--max-context 122880 --kv q4_0 --peer-device 1 --remote-expert-opt --peer-reserve-mib 2048 --kv-resident 20480

[strata] experts loaded: 46.84 GiB at 2.58 GiB/s (32 s so far)
[strata] filling the GPU's expert cache (4769 experts, 9.03 GiB of VRAM) ...
ready: http://127.0.0.1:8080/v1  (context 122880 tokens)
Итог по VRAM (nvidia-smi): GPU 0 — 15.9 из 16.4 ГБ, GPU 1 — 14.8 из 16.4. Впритык, но стартует за 40 секунд и держится. Свободные ~1.3 ГБ на второй карте — это не пропащий ресурс, а тот самый резерв под prefill-буферы; именно из-за его нехватки всё и падало.
Веб-UI и телеметрия
Strata поднимает свой веб-интерфейс прямо на http://<ip>:8081/ — чат, настройки сэмплирования и переключатель Thinking. Ничего не уходит с машины, всё локально.
Скорость в цифрах
Вкладка Monitor в веб-UI Strata показывает живую телеметрию. Реальные цифры после прогона:
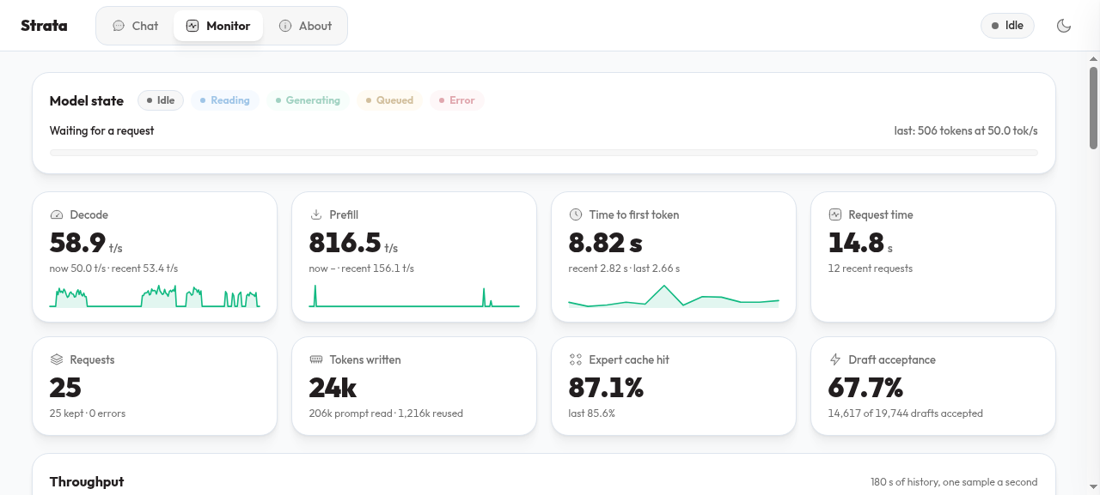
- Decode: 50–59 ток/с.
- Prefill: 816 ток/с (промпт на 50K+ токенов проглатывается за минуту).
- Time to first token: ~2.7 с.
- Expert cache hit: 87% — то есть 87% экспертов берутся прямо из VRAM, без PCIe.
- Draft acceptance: 67.7% (спекуляция окупается).
- Experts in VRAM: 4769 слотов / 9.0 ГБ.
- Context fill: 64% (79K из 120K занято).
Для агентной работы (tool-вызовы, код, длинные контексты) — более чем комфортно.
Соседство с llama-server
На тех же двух V100 у меня живёт и обычный llama-server (Qwen3.8-27B, порт 8080). Два сервера в 2×16 ГБ не помещаются — Strata съедает почти всю VRAM. Поэтому переключение между ними — двумя скриптами, которые сначала гасят одного, потом поднимают другого:
# strata-up.sh — переход на Strata (:8081)
docker stop llama-server
docker start strata
# ждёт строку "ready: http" в логе, до 150 с

# llama-up.sh — переход на llama-server (:8080)
docker stop strata
docker start llama-server
# ждёт /health на :8080, до 120 с
Порты разведены: llama-server на 8080, Strata на 8081 (8080 внутри контейнера проброшен наружу на 8081, чтобы не конфликтовать).
Подводные камни
- «Сервер висит 1–3 минуты при старте» — это нормально. Strata грузит 55 ГБ в RAM и локирует их; в это время машина реально может тормозить. Не закрывайте окно.
- Два режима режут память по-разному.
layer_split(слои пополам между картами) и--peer-device(вторая карта = слой экспертов) — это разные стратегии. Наlayer_splitу меня влезал даже контекст 262144, но expert cache был меньше. На--peer-devicehit-rate выше, но VRAM впритык и нужен резерв. - Не смешивайте.
--peer-deviceнесовместим с--layer-splitи--expert-cache-device1..3. - Нет api_key — модель открыта всей локалке. Strata сам предупреждает. Для домашней сети терпимо, но в конфиг стоит вписать
"api_key". - q4_0 KV — это компромисс. 4-битный KV экономит память, но теоретически чуть роняет качество на очень длинных контекстах. Hadamard-поворот потерю смягчает; на агентных задачах разницу я не заметил.
Что работает / что нет
Работает ✓
- ✓ 55-гигабайтная MoE на двух 16-гигабайтных картах.
- ✓ Контекст 122880 при KV в 4 бита и стриминге.
- ✓ 50–60 ток/с, prefill 816 ток/с, expert cache 87%.
- ✓ OpenAI-совместимый API (
/v1/chat/completions) — подключается куда угодно.
Не работает / осторожно ✗
- ✗ Два LLM-сервера одновременно в 2×16 ГБ — только переключением.
- ✗
--peer-deviceбез--peer-reserve-mibна забитой карте =gather_rows: out of memory. - ✗ Контекст 262144 на peer-топологии — не влезает, только на
layer_split.
Советы от себя
- Читайте лог до конца — Strata почти всегда пишет подсказку прямо рядом с ошибкой («raise —peer-reserve-mib or lower —peer-prefill-rows»). Это половина решения.
- Начинайте с
layer_split autoи консервативного контекста, убедитесь что стартует, и только потом включайте--peer-device. - Не гонитесь за максимальным контекстом ради цифры. 120K при 4-битном KV и 87% hit-rate лучше, чем 262144 с постоянными OOM.
- Держите RAM с запасом: 55 ГБ модели + KV + буферы на 62 ГБ уже впритык, swap под нагрузкой подтормаживает.
В сухом остатке: Strata превращает «нерелевантную» для таких карт модель в полностью рабочего агента с огромным контекстом. Потрачено полдня на борьбу с VRAM — зато теперь Qwen3.8-Flash-Next крутится дома, ничего не уходит в облако, и тянет задачи, которые на 32 ГБ видеопамяти раньше просто не стартовали.